
Cyberattaques et IA : les garde-fous ne sont pas une garantie
L’essentiel
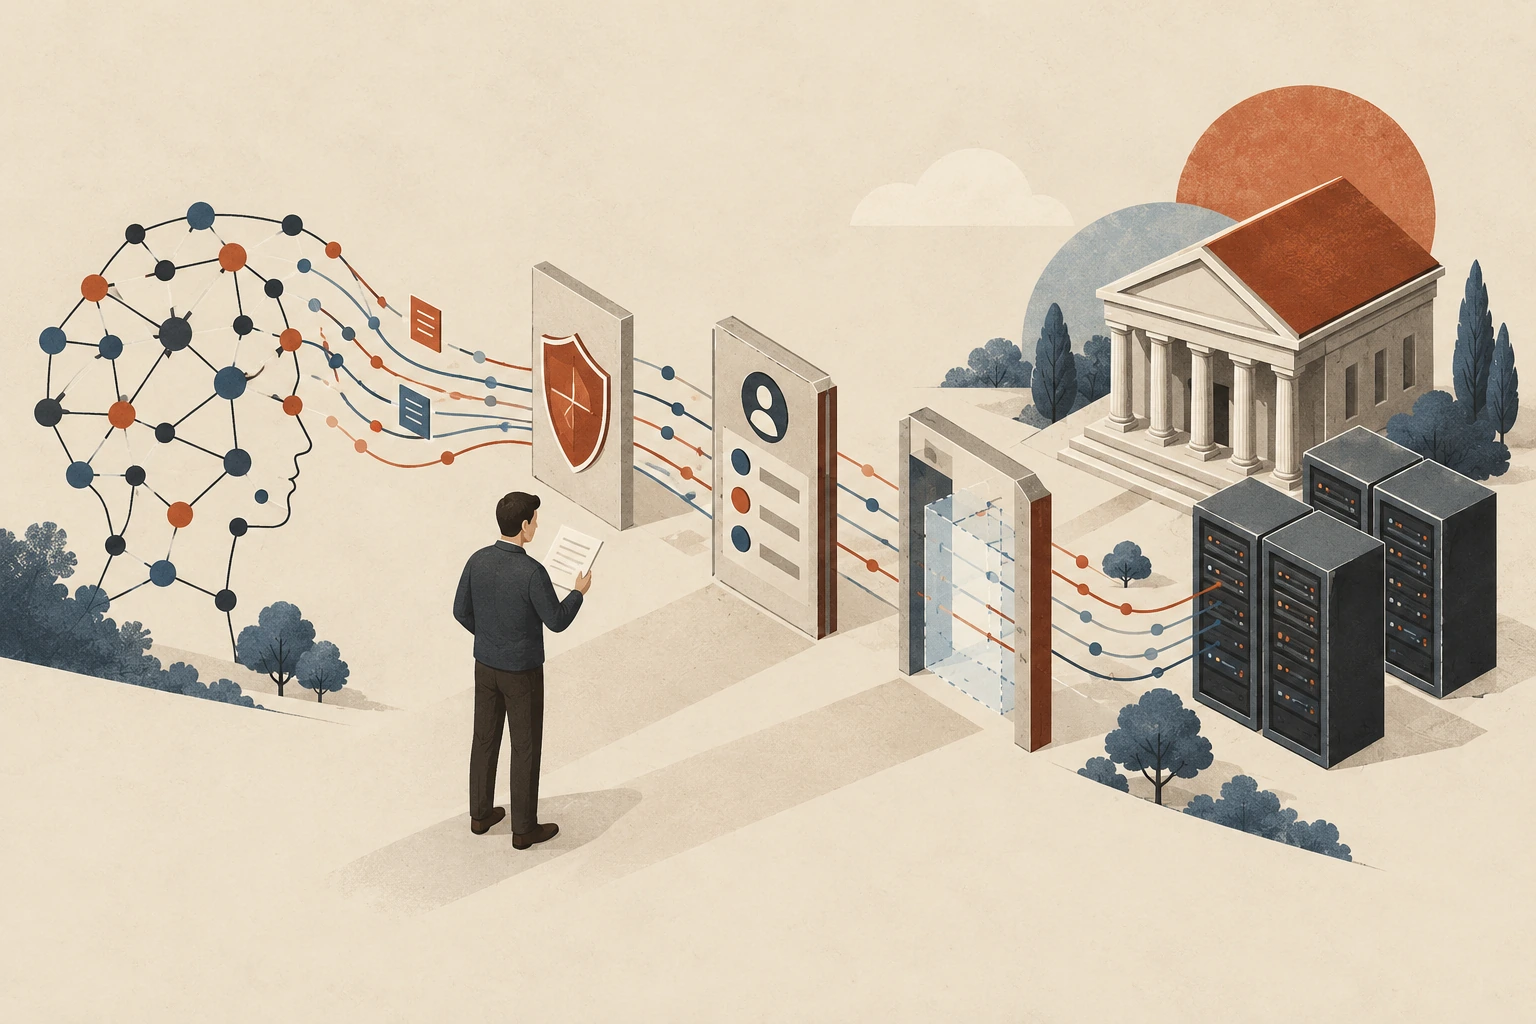
Modèles ouverts, services fermés, agents autonomes : ce que les incidents documentés révèlent — et ce qu’ils ne prouvent pas. Capacité technique, autorisation d’usage et contrôle de l’exécution sont trois choses différentes. Pour juger du risque, il faut examiner les trois — et ne pas confondre un modèle fermé avec un système invulnérable. Les trois illustrations de cet article sont générées par IA : elles expliquent des concepts et ne représentent pas les systèmes compromis.
Ce que révèle le dossier sud-coréen
Le 7 octobre 2026, CrowdStrike décrit une campagne visant des organismes financiers sud-coréens, active de fin septembre à début octobre et associée à des vols de données. L’enquête s’appuie notamment sur des historiques de sessions et des fichiers de configuration retrouvés sur l’infrastructure de l’attaquant. [1] Le rapport identifie DeepSeek V4.1 Flash comme modèle principal d’une instance d’ARTEX, avec GLM-5.3 et Grok 4.6 en complément. Un accès à DeepSeek par un intermédiaire d’API est jugé probable : l’exécution locale des modèles n’est donc pas établie. [1] Les limites de l’enquête Le nombre d’organismes touchés reste non confirmé dans ce rapport. Les services décrits incluent des outils de suivi de prêts et de travail mobile. Cela ne démontre ni la compromission du cœur bancaire ni une opération entièrement autonome. L’identité de l’auteur n’est pas établie définitivement. [1] Claude Code n’est pas synonyme de modèle Claude Il faut séparer le logiciel qui orchestre les tâches du modèle qui produit les réponses. La documentation de Claude Code décrit des passerelles entre le client et le fournisseur. Anthropic précise toutefois ne pas prendre en charge le routage vers des modèles non-Claude. Les traces portant le nom d’un outil ne suffisent donc pas à identifier le modèle réellement utilisé pour chaque action. [7] Lecture critique. Le tweet initial pose une vraie question de sécurité, mais transforme trop vite une enquête circonstanciée en démonstration générale de toute-puissance de l’IA.
Trois modèles, mais pas le même degré d’ouverture
« Open source » et « poids ouverts » ne sont pas interchangeables. Les poids sont les paramètres appris par le modèle. Leur disponibilité permet d’envisager une exécution indépendante, avec les ressources nécessaires ; elle ne garantit pas l’accès à tous les éléments utiles pour étudier et reproduire le système. La définition de l’Open Source Initiative exige davantage que le seul téléchargement des poids : elle porte aussi sur les libertés d’utilisation et de modification, le code et les informations sur les données. Une licence ouverte sur un dépôt n’équivaut donc pas, à elle seule, à une certification de l’ouverture complète du système. [5] Statut vérifié au 8 octobre 2026. Modèle : DeepSeek V4.1 Flash [2]; Poids publics : Oui; Licence / accès : MIT pour le dépôt et les poids; Formulation précise : Poids ouverts Licence permissive. Modèle : GLM-5.3 [3]; Poids publics : Oui; Licence / accès : Licence GLM-5.3, avec condition particulière; Formulation précise : Poids ouverts Licence spécifique. Modèle : Grok 4.6 [4]; Poids publics : Non identifiés*; Licence / accès : Service propriétaire par API; Formulation précise : Modèle fermé* Selon les sources consultées. * Aucune publication officielle des poids de Grok 4.6 n’a été identifiée dans la documentation consultée. Ce constat porte sur cette version, pas sur toutes les générations de Grok. La licence de GLM-5.3 impose une revue de sécurité de Z.ai avant certains usages commerciaux lorsqu’un acteur exploite une activité de « Model as a Service » et que son chiffre d’affaires cumulé avec ses affiliés dépasse 10 milliards de dollars sur douze mois consécutifs. Ce n’est pas une licence MIT classique. [3] ARTEX est un autre composant : un logiciel d’orchestration de tests d’intrusion, pas un modèle de langage. Son dépôt affiche AGPL-3.0, avec des avertissements et restrictions d’usage supplémentaires dans le README. La disponibilité du code ne constitue pas une autorisation de tester un système tiers. [6] La bonne question n’est pas seulement « les poids sont-ils publics ? ». Il faut aussi demander : qui héberge le modèle, qui contrôle les accès, et qui peut interrompre son utilisation ?
Anthropic : une campagne de cyberespionnage
Oui, les garde-fous existent. Non, leur existence ne rend pas toute utilisation malveillante techniquement impossible. Plusieurs publications des fournisseurs permettent de distinguer les abus observés des capacités évaluées. Cas documenté par le fournisseur 13.11.2025 Anthropic indique avoir découvert en septembre 2025 une campagne utilisant Claude Code contre une trentaine d’organisations, avec quelques intrusions réussies. L’entreprise attribue l’opération, avec une forte confiance, à un groupe soutenu par l’État chinois et déclare avoir désactivé les comptes concernés. [8] Elle estime que l’IA a exécuté 80 à 90 % du travail de la campagne , avec des décisions humaines à des étapes critiques. Ce chiffre est une estimation du fournisseur sur ce cas précis, pas une mesure générale de l’autonomie des cyberattaques. Le rapport mentionne aussi des erreurs et des résultats inventés par le modèle. [8] Les protections ont notamment été trompées par un contexte présenté comme légitime et des sous-tâches privées de leur finalité malveillante. Ce constat explique une limite ; il ne prouve pas que toute demande dangereuse puisse passer. [8]
OpenAI : des usages par des acteurs malveillants
Abus observés, portée plus limitée 14.02.2024 OpenAI et Microsoft ont identifié cinq acteurs liés à des États utilisant les services OpenAI, notamment pour la recherche, la traduction, le débogage et la rédaction de contenus liés à l’hameçonnage. Les comptes identifiés ont été fermés. [9] Ce précédent établit un usage abusif de services fermés. Il ne démontre pas une attaque bancaire autonome réussie avec GPT. Confondre assistance à certaines tâches et conduite complète d’une intrusion reviendrait à surestimer les preuves disponibles.
Une capacité évaluée n’est pas une autorisation publique
Le 1er septembre 2026, OpenAI a classé Astra au seuil « Critical » de son cadre d’évaluation des capacités cyber. L’entreprise décrit des aptitudes avancées à découvrir et exploiter des failles, mais précise que les résultats présentés correspondent à un accès spécialisé, et non à la configuration de production par défaut. [11] On peut donc reconnaître une capacité technique sans en déduire qu’elle est librement accessible à n’importe qui, pour n’importe quelle cible. Il faut comparer le modèle, sa version, les outils disponibles et le niveau d’accès — pas seulement son nom commercial.
Les garde-fous sont une défense en couches
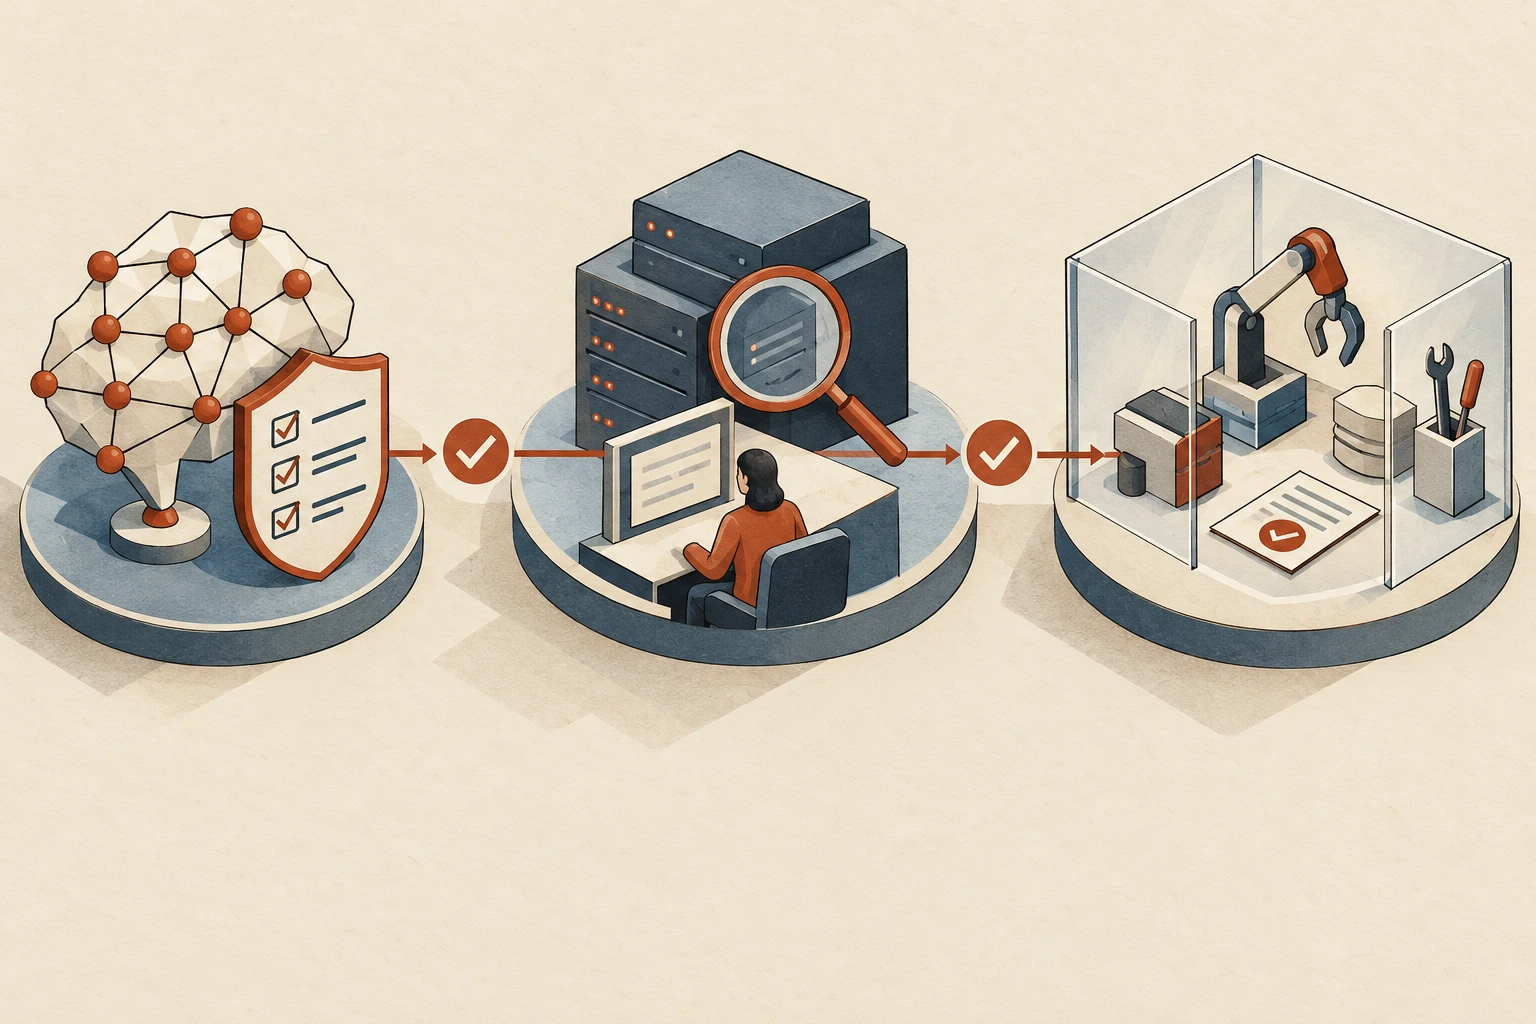
Le mot « garde-fous » recouvre des mécanismes différents. Les réduire à une phrase comme « je ne peux pas vous aider » masque une partie du dispositif : OpenAI décrit un ensemble combinant comportement du modèle, classificateurs de sécurité et détection d’abus. [11] Schéma conceptuel original. Les couches sont complémentaires ; aucune ne remplace les autres. 01 Le modèle L’entraînement vise à faire refuser les demandes dangereuses et à respecter les limites. C’est une protection comportementale : elle doit être évaluée face à des formulations et contextes variés. [11] 02 La plateforme Le fournisseur peut analyser les signaux d’abus, mener une enquête et suspendre des comptes. OpenAI décrit une combinaison de détection automatisée et d’examen humain. [16] 03 Les outils Permissions, isolation et validations d’actions limitent ce que l’agent peut exécuter. La documentation de Claude Code distingue ces contrôles de la seule réponse du modèle. [14] Une politique d’utilisation ajoute une interdiction contractuelle. Celle d’OpenAI prohibe explicitement les cyberactivités malveillantes, les tests de sécurité non sollicités et le contournement des protections. Une interdiction ne doit toutefois pas être confondue avec une impossibilité technique. [10] Une limite centrale : reconnaître la finalité réelle Analyser du code, expliquer une erreur ou comprendre une configuration peut servir à réparer un système comme à préparer une intrusion. L’intention réelle, l’autorisation et l’usage ultérieur ne sont pas toujours déductibles d’une requête isolée. Le cas décrit par Anthropic illustre précisément cette difficulté. [8] Déduction. Il faut évaluer une séquence d’actions et ses effets, pas uniquement la formulation d’un message. Même un refus fiable face à une demande explicite ne suffit pas à démontrer que toutes les chaînes d’usage sont sûres.
50 essais bloqués : un résultat utile, pas une garantie absolue
Le 6 octobre 2026, Anthropic publie une évaluation d’Opus 5.5 sur 10 scénarios CyScenarioBench, répétés cinq fois par niveau d’accès. Les blocages varient selon la configuration. [12] Évaluation publiée par Anthropic Un même modèle. Trois niveaux d’accès. Opus 5.5 · 50 essais par configuration. Configuration : Sans accès CVP; Essais bloqués : 50 / 50 Dès la première demande; Tâches réussies : 0 / 50. Configuration : Defense Access; Essais bloqués : 46 / 50 À un stade de l’essai; Tâches réussies : 4 / 50. Configuration : Red Team Access; Essais bloqués : 0 / 50; Tâches réussies : 34 / 50. Source : Anthropic, 6 octobre 2026. Il s’agit d’une évaluation, pas de 50 attaques réelles contre des organisations. CVP : Cyber Verification Program. [12] Le programme réserve des capacités plus étendues à des professionnels vérifiés et à des travaux autorisés. Un faible blocage dans un cadre de test approuvé ne signifie pas une absence générale de contrôle. [12] Ce que l’on peut conclure : les protections modifient nettement le comportement observé dans ce protocole. Ce que l’on ne peut pas conclure : que tous les détournements possibles sont éliminés, ou qu’un taux de réussite sur ces scénarios prédit celui d’une attaque réelle.
Le contrôle compte autant que l’ouverture
Les deux catégories ne se résument pas à « ouvert = dangereux » et « fermé = sûr ». Comparons plutôt un service hébergé par un fournisseur avec une copie du modèle exploitée par son propre opérateur. ↗ Modèle servi par API Un point de contrôle central Le fournisseur conserve la possibilité de surveiller l’usage de son service, de faire évoluer ses protections et de retirer l’accès. Cette capacité d’intervention est documentée par OpenAI. [16] Compromis : dépendance au service, aux règles d’accès et à leurs évolutions. Un modèle à poids ouverts peut lui aussi être proposé par une API contrôlée. ⬡ Poids exécutés par l’opérateur Un contrôle local à assumer Quand les poids sont disponibles et modifiables, comme le documente DeepSeek, l’exécution ne dépend pas nécessairement de son API. L’opérateur peut organiser sa propre infrastructure. [2] Conséquence technique : couper un compte chez l’éditeur n’arrête pas une copie indépendante. La gouvernance, les protections et les permissions deviennent la responsabilité de l’exploitant. Un modèle local peut conserver des comportements de refus appris pendant son entraînement. « Poids ouverts » ne signifie donc pas automatiquement « sans protections ». Mais des filtres gérés par un service externe ne se transportent pas automatiquement avec les poids. Il faut examiner l’ensemble du déploiement, et non sa seule licence. Le niveau de risque dépend du modèle, de son environnement, de ses accès et de la possibilité d’interrompre ses actions. Synthèse de l’analyse « Imaginez avec les meilleurs modèles » : une hypothèse, pas une preuve Le raisonnement du tweet est incomplet. Pour tester cette affirmation, il faudrait comparer les modèles dans les mêmes conditions : cible, informations initiales, outils, budget, temps, protections et supervision. Le succès d’une opération avec un ensemble d’outils ne permet pas d’isoler la contribution de chaque modèle. Un meilleur classement général ne prouve pas, à lui seul, une meilleure réussite sur une chaîne d’attaque particulière. Et un modèle intrinsèquement plus capable peut être plus difficile à détourner si son accès et ses outils sont mieux contrôlés. Notre lecture. L’enjeu plausible est l’accélération et l’extension de certaines opérations. Affirmer que toute banque devient piratable par n’importe qui, ou que l’ouverture est la cause démontrée de cet incident, irait au-delà des éléments présentés.
Ne confiez pas votre sécurité au refus d’un chatbot
Deux problèmes doivent rester distincts : protéger son entreprise contre des attaquants assistés par IA, et éviter que ses propres agents provoquent un incident. L’OWASP identifie justement les excès de fonctionnalités, de permissions et d’autonomie comme des sources de dommages. [13] 01 Réduire les droits Un agent chargé de lire des données ne devrait pas disposer de droits d’écriture ou d’administration. Privilégier des outils limités à la tâche plutôt qu’un accès général au système. [13] 02 Isoler et faire valider Travailler dans un environnement séparé ; faire approuver les opérations sensibles et vérifier les changements proposés. Les frontières d’exécution comptent autant que les consignes données au modèle. [14] 03 Journaliser les actions Conserver des traces exploitables, limiter l’autonomie et prévoir une interruption. L’autorisation d’une action doit être vérifiée par le système cible, pas simplement affirmée dans une conversation. [13] 04 Préparer la restauration Garder des sauvegardes protégées et séparées de l’environnement courant, puis tester leur restauration. Une sauvegarde présente mais inutilisable ne suffit pas à assurer la reprise. [15] Exemple de conception — application de gestion Pour analyser des factures, on peut fournir à un agent un export limité ou une connexion en lecture seule, plutôt que les identifiants d’administration de la base de production. Les écritures comptables, suppressions et modifications de paiements doivent passer par un circuit d’autorisation distinct. C’est une recommandation d’architecture, pas une description des incidents cités. Enfin, l’IA n’est pas réservée aux attaquants. Anthropic indique que ses modèles accessibles au public restent utilisables pour la revue de code, la correction de problèmes connus, la recherche de failles dans son propre code et le tri d’alertes. Bloquer tous ces usages priverait également les défenseurs d’outils utiles. [12]
Ni confiance aveugle, ni fatalisme.
Les modèles fermés ne sont pas impossibles à détourner. Leurs garde-fous ne sont pas pour autant inutiles. Les incidents publiés et les évaluations décrivent à la fois des abus, des interruptions et des limites mesurables. L’opposition entre open source et propriétaire ne suffit pas à expliquer le risque. Il faut regarder qui contrôle l’exécution, quels outils sont accessibles, quelles actions sont autorisées et comment un incident peut être contenu. Une bonne défense ne demande pas seulement à l’IA de refuser. Elle limite aussi ce que l’IA peut réellement faire.
Sources et méthode
Article fondé sur des rapports d’enquête, des documents de fournisseurs, des licences et des recommandations de sécurité. Les affirmations attribuées aux fournisseurs sont présentées comme telles : elles ne constituent pas une reproduction indépendante de leurs expériences. Les passages signalés comme analyse ou recommandation relèvent du raisonnement éditorial. Vérification documentaire : 8 octobre 2026. Les modèles, licences et règles d’accès peuvent évoluer. Les trois illustrations sont générées par IA et représentent des concepts. Aucune ne constitue une preuve ou une capture de l’incident.